
חברת OpenAI מעסיקה מאות עובדי קבלן המורשים לקרוא ולדרג שיחות אמת של משתמשים עם הצ'אטבוט הפופולרי ChatGPT, כך נחשף בעקבות תחקיר גוף התקשורת 404 Media.

על פי הממצאים, אף על פי ששמות המשתמשים מוסתרים מהסוקרים, מופיע לנגד עיניהם סיכום של זיכרון המשתמש. נתונים אלו כוללים לעיתים תכופות מידע על שימושי עבר של הלקוח בצ'אטבוט ואף את האזור הגיאוגרפי שבו הוא שוהה.
הפילטר הבעייתי והתחמקות החברה משאלות שקיפות
ב-OpenAI טוענים כי המערכת משתמשת במסנן פרטיות ייעודי שתפקידו להסיר מידע מזהה בטרם השיחות מועברות לעיניים אנושיות.
עם זאת, עמוד המוצר הרשמי של אותו מסנן מודה בגלוי כי הטכנולוגיה אינה חסינה מטעויות: היא עלולה להחמיץ מזהים נדירים ולפספס הסתרת פרטים רגישים כאשר ההקשר השיחתי מוגבל.
כאשר התבקשה החברה להצביע על המקום המדויק שבו היא מיידעת את המשתמשים על כך שבני אדם עשויים לקרוא את שיחותיהם, נמנעה OpenAI מלהשיב באופן ישיר ורק לאחר פרסום התחקיר הפנתה לעמוד עזרה כללי.
החלטת בית המשפט באירופה והקנס באיטליה
הפרקטיקה הזו מעמידה את החברה במסלול התנגשות ישיר מול הרגולציה האירופית. פסיקה של בית המשפט לצדק של האיחוד האירופי קבעה כי חובת היידוע של חברה האוספת נתונים חלה ברגע הכניסה עצמו, ואינה תלויה בשאלה האם צד שלישי מסוגל לזהות את האדם שמאחורי הטקסט.

הרשות להגנת הפרטיות באיטליה כבר קנסה את OpenAI בסכום של 15 מיליון אירו, תוך הוראה לחייב אותה בקמפיין פרסום ואזהרה בטלוויזיה וברדיו המקומיים. במקביל, שחקניות נוספות בשוק כמו אנתרופיק וגוגל מפעילות מנגנוני סקירה אנושית דומים, אך מציינות זאת באופן ברור יותר או מתנות זאת באישור פעיל מצד המשתמש.
אפליה בין משתמשים פרטיים לעסקיים
הפער המרכזי בגישת החברה טמון בהגדרות מחדל. בעוד שללקוחות עסקיים וארגוניים מוצעת מדיניות של אפס שמירת נתונים והחרגה מלאה מאימון המודלים, משתתפי המסלולים החופשיים ומנויי הפרימיום הפרטיים מוחרגים מאימון המודל רק אם שינו באופן אקטיבי את הגדרות חשבון.

שינוי כזה תקף בלבד לשיחות עתידיות ולא לאלו שכבר נערכו. בעוד החברה מעודדת את המשתמשים הפרטיים לחבר את חשבונות הבנק שלהם לשירות, רבים מהם כלל אינם מודעים לכך שקבלן חיצוני בצד השני של העולם עשוי לנתח את ההודעות האישיות שלהם.
מה עושים?
כדי לשמור על פרטיותכם ולמנוע מעובדים לקרוא את השיחות שלכם, יש לבצע שינוי הגדרה קל: היכנסו להגדרות של ChatGPT, לכו להגדרה "בקרת נתונים" (Data Controls) וכבו את האפשרות "שפר את המודל עבור כולם" (Improve the model for everyone).
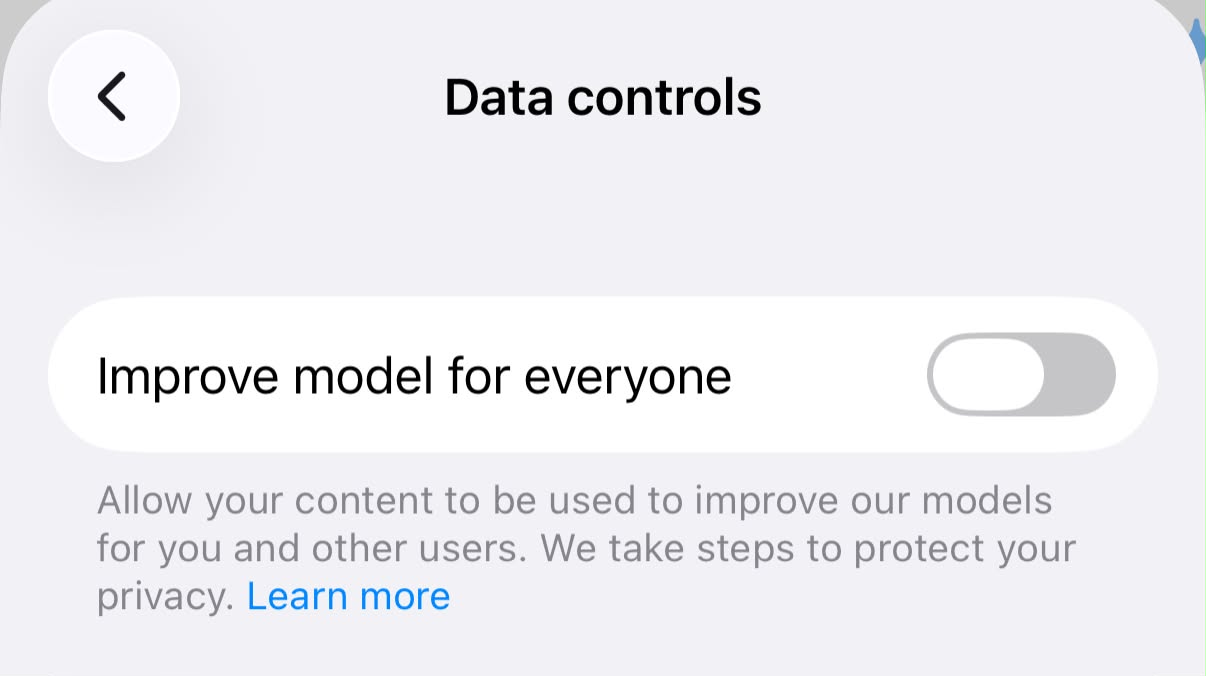
הגדרה זו פועלת כברירת מחדל בכל החשבונות החינמיים ואלה שבתשלום, כאשר לאחר מכן השיחות העתידיות שלכם לא יועברו לגורמים חיצוניים.